/api/agent/v1 配下のエージェントコンテキスト REST API は、順位付け・重複排除・引用付きの証拠とガバナンス付きコンテキストセットを返します。
エージェントコンテキスト API
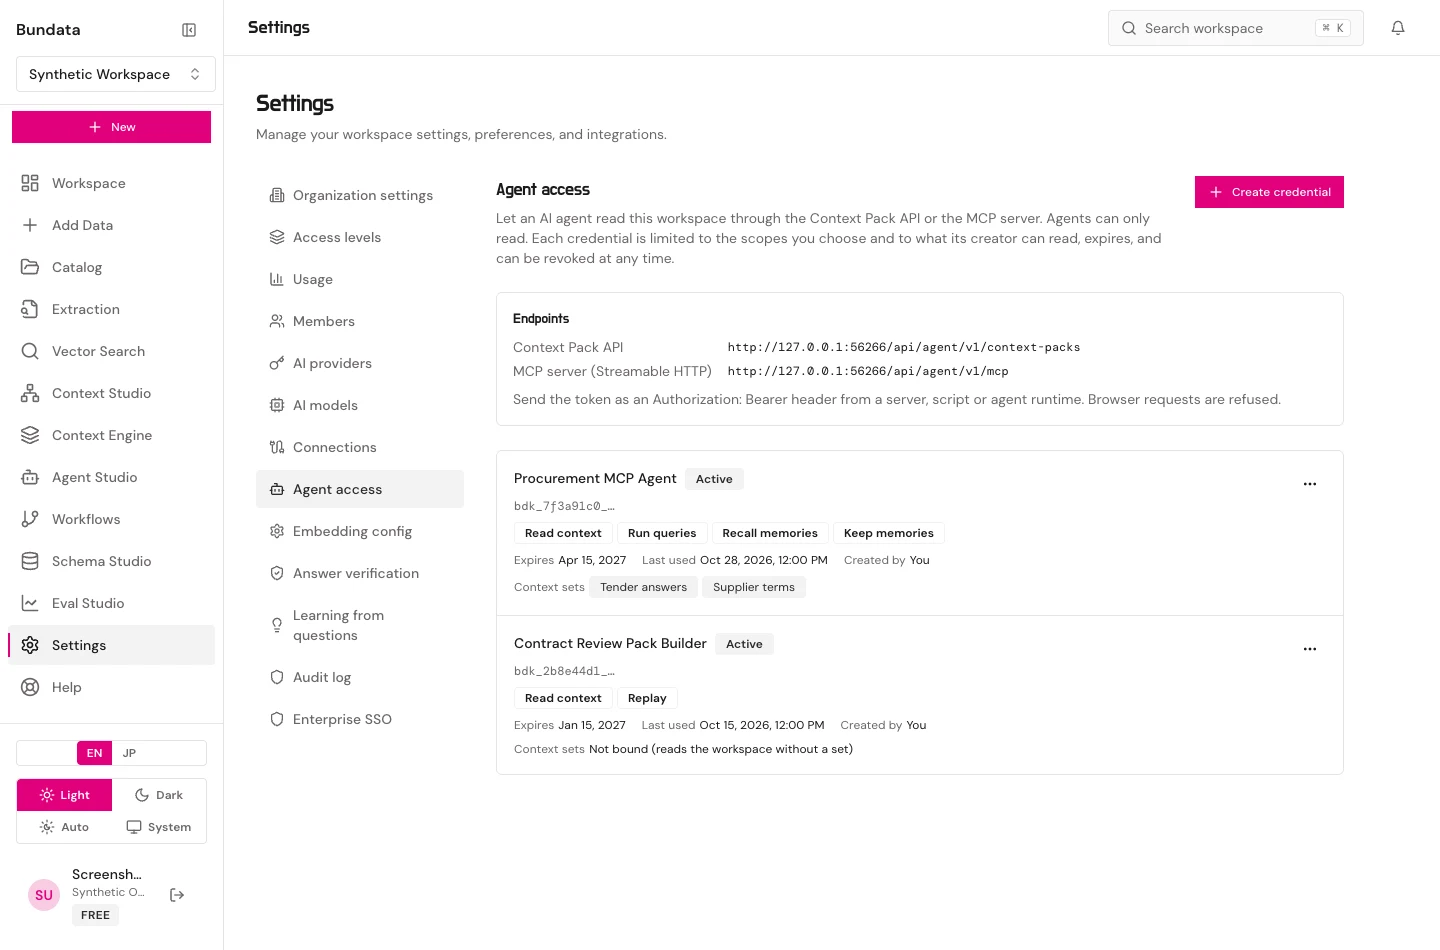
エージェントコンテキスト API は、Bundata API サーバーの /api/agent/v1 配下で提供されます。すべてのリクエストは、設定 → エージェントアクセス で作成したスコープ付き認証情報(Authorization: Bearer bdk_<16 hex>_<43 base64url>)で認証します。
認証情報とスコープ
ワークスペースの owner と admin(agent_credential:manage)は、保存型ワークスペースあたり最大 50 個の有効な認証情報を管理できます(POST /api/w/:wsId/agent-credentials)。各認証情報は 1〜365 日で失効し、作成者の現在のワークスペース権限で動作し(権限喪失時は AGENT_CREDENTIAL_AUTHORITY_LOST)、ブラウザからのリクエスト(Origin または Sec-Fetch-* ヘッダー)を 403 AGENT_BROWSER_REQUEST_REFUSED で拒否します。
| スコープ | 作成者の最小ロール | 許可される操作 |
|---|---|---|
context:read | Viewer(collection:read、document:read) | コンテキストパック、パッセージ・グラフ・セクション・引用ツール、テンポラルグラフ読み取り、コンテキストセット検索、学習済みフィールドツール(list_fields、query_fields) |
queries:run | Editor(document:read、agent:run) | パック内の文書全体証拠、検証済みルールテンプレート、承認済み SQL クエリテンプレート(run_query_template) |
replay:run | Viewer(document:read) | POST /api/agent/v1/replays/:replayId(verify または recompute) |
gaps:report | Viewer(library:read) | MCP の report_context_gap(認証情報作成時の既定はオフ) |
memory:read | Viewer(collection:read、document:read) | 作成者のエージェントメモリの想起と一覧(既定はオフ) |
memory:write | Editor(document:read、agent:run) | 作成者のエージェントメモリの記憶と削除(既定はオフ) |
コンテキストパックとリプレイ
POST /api/agent/v1/context-packs(および application/x-ndjson ストリーム用の /api/agent/v1/context-packs/stream)は、トークン予算内で決定論的に順位付け・重複排除された引用付き証拠パックを構築します。
curl -sS "$BUNDATA_URL/api/agent/v1/context-packs" \
  -H "Authorization: Bearer $BUNDATA_AGENT_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "task": "Who is the current CFO, and since when?",
    "budget": { "maxTokens": 2000, "coverage": "best_effort" },
    "asOf": { "validTime": "2025-01-01T00:00:00Z" }
}'- リクエストフィールド:
task(1〜4,000文字)、budget.maxTokens(256〜32,000、既定4,000)、budget.maxLatencyMs(1,000〜60,000、既定15,000)、budget.coverage(best_effortまたはrequire_complete)、asOf(validTime、systemTime)、filters(collectionIds最大 8 個、documentIds最大 20 件、sources:passages、graph、documents)、retrieval(hybridまたはlexical)、および任意のcontextSetId。 - セット優先パッキング:
contextSetIdが指定された場合(または認証情報が 1 つの有効な コンテキストセット にバインドされている場合)、予算はverified_answers、definitions、instructions(trust: "approved"としてマーク)、required_evidence、evidence、whole_documentの順に埋められます。 - 信頼できない文書テキスト: 文書から引用されたすべての項目には
trust: "untrusted"、およびvalidity、superseded、contradictionフラグが付与され、返却前に読み取り権限が再確認されます。 - リプレイ(
POST /api/agent/v1/replays/:replayId、{ "mode": "verify" | "recompute", "task"?: string }): 記録されたすべての項目を現在の文書と照合(unchanged、changed、unavailable)するか、記録時点の条件でパックを再構築して差分を返します。リプレイ記録はハッシュのみを保持し、30 日後に失効します(410 AGENT_REPLAY_EXPIRED)。
コンテキストセットとライブラリのルート
以下の 4 つのルートはすべて context:read を必要とし、プロバイダーの埋め込み予算を消費せずに単語一致で照合し、コンテキストセットのスコープを強制します。
POST /api/agent/v1/context-sets/list({ query?, limit? })POST /api/agent/v1/context-sets/get({ contextSetId? })POST /api/agent/v1/definitions/lookup({ term, contextSetId?, limit? })POST /api/agent/v1/verified-answers/match({ question, contextSetId?, limit? })
学習済みフィールドとクエリテンプレート
- 学習済みフィールド(
POST /api/agent/v1/fields/listおよびPOST /api/agent/v1/fields/query、スコープcontext:read): コレクションの正規化された学習済みフィールド(number、money、date、boolean、text)を確認し、構造化プラン(最大 6 個のfields、6 個のfilters、sort、最大 200 行のlimit、最大 50 グループのgroupByを伴うcount/min/max/sum/avgのaggregate、および任意のknownAt: "YYYY-MM-DD")を実行します。各値にはリアルタイムで検証されたパッセージスパン引用(citation、またはuncitedReason付きのnull)が含まれ、記載率が 90% 未満のフィールドがある場合はcoverageLinesとincompleteで示されます。 - クエリテンプレート(
POST /api/agent/v1/query-templates/run、スコープqueries:run):{ templateId, parameters, contextSetId? }を渡して、有効なコンテキストセットに属する承認済み PostgreSQL クエリテンプレートを実行します。エージェントが生の SQL を送受信することはありません。