コンテキストポリシーを変えても再埋め込みはしません。コレクションのプロファイルは、既にあるベクトルと一致している必要があります。
インデックスの準備
harbor-note.txt を抽出済みテキストから、インデックス済みコレクションへ進めます。手を動かす時間は約 20 分です。埋め込みとインデックスのジョブは別です。
目的
検索を実行してよいか言えます。レベルは編集者です。ロールはワークフローの公開と、そのワークスペースが求める処理権限です。モードは保存型です。キャンバスのクリックは コレクションをインデックスする にあります。このページは準備の契約です。
前提
抽出が Smart Bite を出したか、文書が chunked を過ぎています。コレクションの埋め込みプロファイルは、そのベクトルが既に使っているものです。別のプロファイルで作ったコレクションに、画面のプロバイダ、モデル、次元を写さないでください。
サンプル
テキスト一つ、承認済みスキーマ一つ、専用のインデックス画面は期待しません。Bundata に、トグルで有効にする Indexes ページはありません。
手順
- コレクションで状態を読みます。
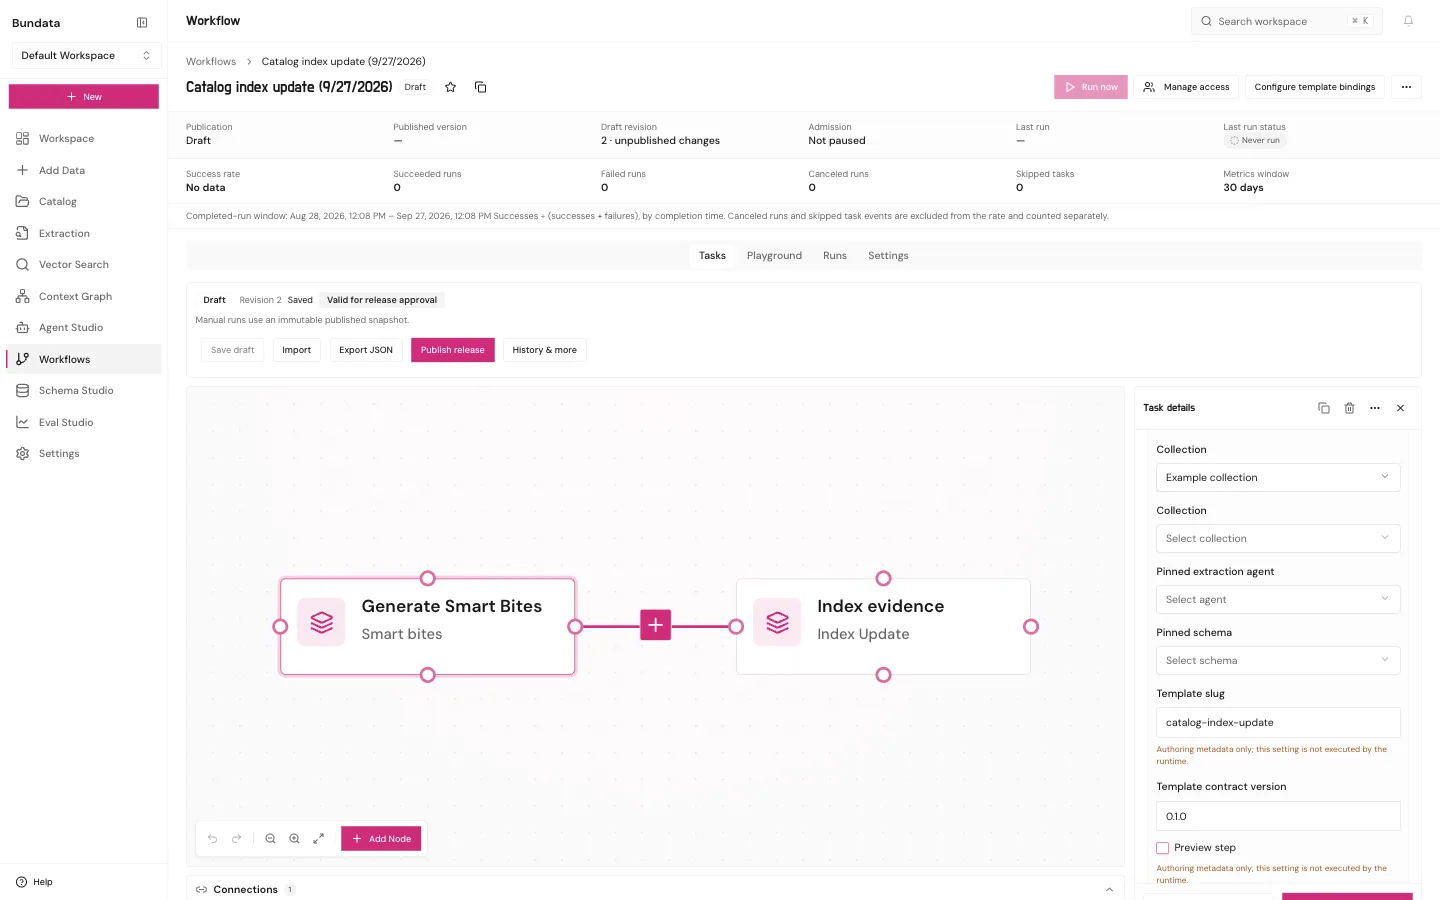
readyは本文があることです。indexedはベクトルが書かれたことです。errorは止まって実行を読むことです。 - インデックス更新のワークフローを開き、このコレクションを結び、既存の埋め込みプロファイルに合わせます。
- 下書きを保存し、リリースを公開し、そのリリースを実行します。保存したグラフはインデックスではありません。
- Catalog に戻ります。状態が Indexed でベクトル数が 0 より大きいときだけ、そのコレクションを検索に使います。
フィールド
| 信号 | 検索してよい? |
|---|---|
文書の processing | いいえ。まだパイプラインの中です。 |
ready | 本文だけです。ベクトルではありません。 |
indexed かつベクトル数 > 0 | はい。そのコレクションについてです。 |
| コンテキストポリシーのモデルや topK の変更 | 再構築しません。次の回答は変わります。ベクトルは残ります。 |
| ワークスペース既定の埋め込みの変更 | このコレクションは移しません。 |
例
投稿する「インデックスを作る」JSON はありません。実行単位は、公開したワークフローのリリースです。リリース ID と実行 ID を残します。
回復
indexed の前に実行が失敗したら、プロファイルの不一致か、欠けているプロバイダ鍵を直し、公開済みリリースを再実行します。ベクトルを出すために非保持を保存型へ切り替えないでください。Anthropic の鍵は、OpenAI の埋め込みプロファイルを満たしません。
制限
Haystack 型のインデックスオブジェクト、Enable ボタン、ポリシー編集が再埋め込みするという約束はありません。
確認
成功: Catalog が Indexed と、0 より大きいベクトル数を示します。失敗: 状態が ready または error のままなら、セマンティック検索は試みません。