検索タブのラボです。五つの段階は、質問の理解、ソースの取得、ランキングと証拠、文書の分析、回答の合成 です。埋め込みはインデックス済みコレクションに固定されます。ポリシーは次の取得と回答を調整します。既存の回答もベクトルも変えません。モデル名を選んでも、鍵は用意されず、そのモデルが使えることにもなりません。
コンテキストポリシー
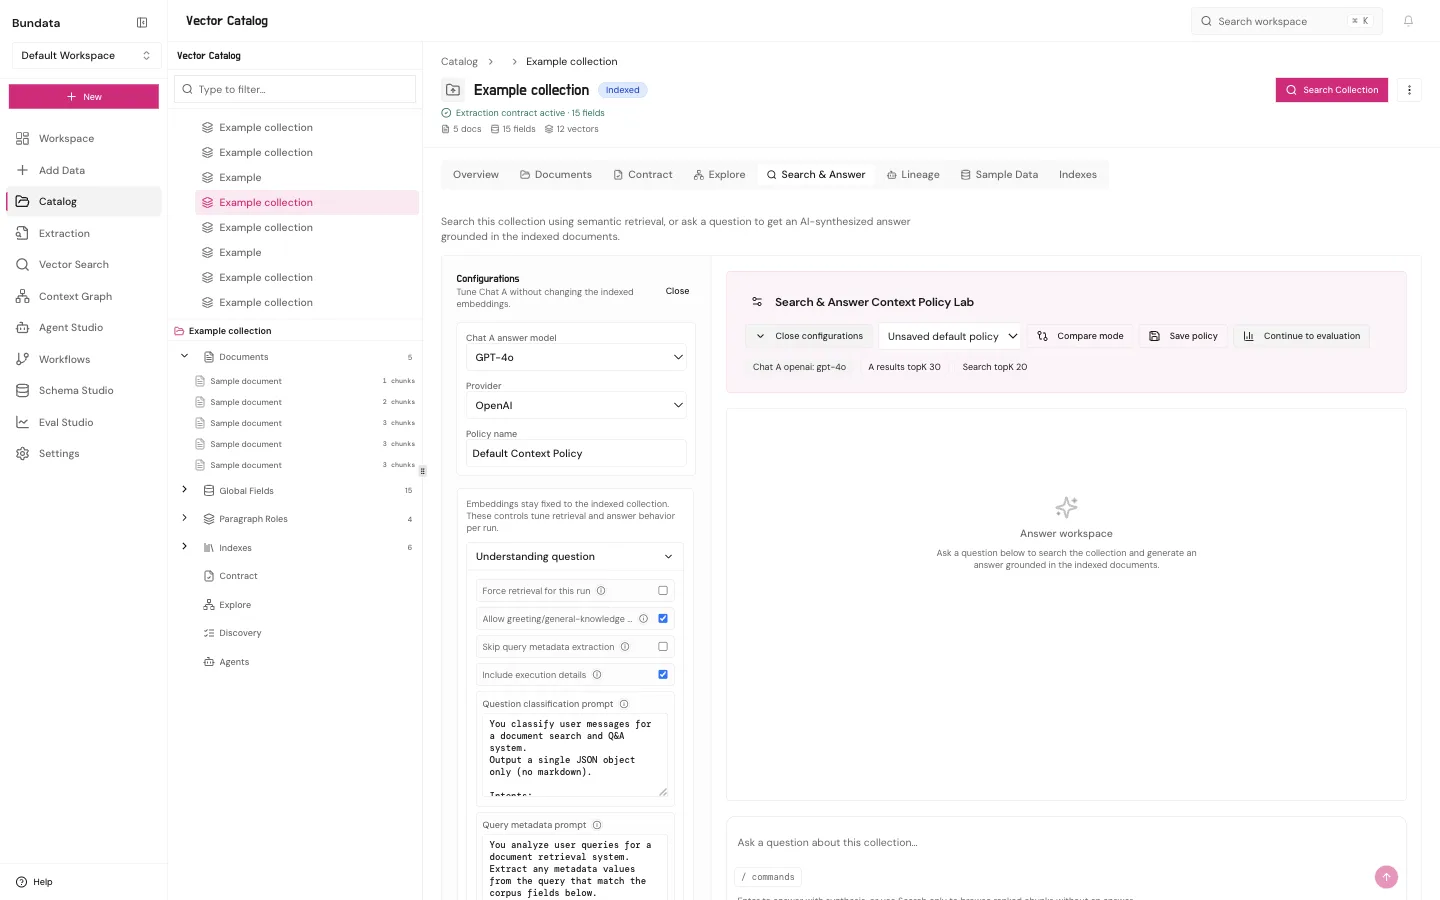
検索タブのラボです。五つの段階は、質問の理解、ソースの取得、ランキングと証拠、文書の分析、回答の合成 です。埋め込みはインデックス済みコレクションに固定されます。ポリシーは次の取得と回答を調整します。既存の回答もベクトルも変えません。モデル名を選んでも、鍵は用意されず、そのモデルが使えることにもなりません。
段階
設定を開くと段階が見えます。Chat A と Chat B は別々に編集します。Chat A の設定を Chat B にコピーする操作はフォームをコピーするだけで、どちらの側も実行しません。
フィールド
| 画面のラベル | キー | 型 | フォームの初期値 | API の範囲 | 次の実行 |
|---|---|---|---|---|---|
| ポリシー名 | policyName | string | 既定のコンテキストポリシー | 1〜180 文字 | ポリシー名として送信されます。埋め込みは変更しません。 |
| プロバイダー | policySnapshot.modelProvider | enum openai | anthropic | google | openai | この 3 つの値 | 次の実行の回答プロバイダーを選びます。キーは用意しません。 |
| Chat A 回答モデル | policySnapshot.model | string | gpt-4o | 1〜160 文字 | Chat A のカタログ回答モデル(synthesis ステップ)、または空欄でワークスペース既定。そのまま実行されるか拒否(MODEL_NOT_IN_CATALOG、MODEL_CHOICE_UNAVAILABLE、MODEL_NOT_APPROVED)され、別モデルへ勝手に差し替えられません。 |
| Chat B 回答モデル | policySnapshot.model | string | gpt-4o-mini | 1〜160 文字 | 比較(Compare)側にのみ使われます。OpenAI、Anthropic、Google を横断して比較できます。 |
| ミニクエリのプロバイダーとモデル | miniQueries.provider, miniQueries.model | enum / string | ワークスペース既定 | カタログの query_expansion モデル | ミニクエリ拡張用の任意のモデル選択。取得処理の前に検証されます。 |
| 温度 | policySnapshot.temperature | number | 0.25 | 0〜2 | 次の回答の多様性を調整します。インデックスは変更しません。 |
| 検索結果 topK | policySnapshot.searchTopK | integer | 20 | 1〜50 | 検索のみで使用します。回答モードでは無視され、回答結果 topK が使われます。 |
| 回答結果 topK | policySnapshot.retrievalTopK | integer | 30 | 1〜50 | 回答および比較で表示される順位付きチャンクの件数です。 |
| この実行では取得を強制 | understanding.forceRetrieval | boolean | オフ | — | 挨拶などであっても常に検索取得を実行します。 |
| 挨拶・一般知識のショートサーキットを許可 | understanding.allowShortCircuit | boolean | オン | — | 挨拶などの場合に分類器がコーパス検索を省略できるようにします。 |
| クエリメタデータ抽出をスキップ | understanding.skipQueryMetadataExtraction | boolean | オフ | — | オンのとき、クエリメタデータ抽出プロンプトを使用しません。 |
| 実行詳細を含める | policySnapshot.includeExecutionDetails | boolean | オン | — | ミニクエリなどの診断情報を表示します。品質スコアではありません。 |
| 質問分類プロンプト | understanding.classificationPrompt | string | ロケール既定文 | 最大 12000 文字 | 英語の既定文と一致する場合はスナップショットから省略されます。 |
| クエリメタデータプロンプト | understanding.queryMetadataPrompt | string | ロケール既定文 | 最大 12000 文字 | クエリメタデータ抽出をスキップがオンの間は無視されます。 |
| ミニクエリを生成 | miniQueries.enabled | boolean | オン | — | オフのとき、ミニクエリの数、上限、閾値、プロンプトは無視されます。 |
| ミニクエリ数 | miniQueries.count | integer | 5 | 0〜12 | ミニクエリを生成がオンになるまで無視されます。 |
| ミニクエリ上限 | miniQueries.limit | integer | 20 | 1〜200 | ミニクエリを生成がオンになるまで無視されます。 |
| ミニクエリ閾値 | miniQueries.scoreThreshold | number | 0.2 | 0〜1 | ミニクエリを生成がオンになるまで無視されます。 |
| ミニクエリプロンプト | miniQueries.promptOverride | string | ロケール既定文(プレースホルダー question、count) | 最大 12000 文字 | 英語の既定文と一致する場合は省略されます。ミニクエリがオフのときは無視されます。 |
| 独立した段階ラベルなし | miniQueries.discount | number | 0.82 | 0〜2 | スナップショットと一緒にシリアライズされます。5 つの段階タイトルではありません。 |
| 証拠モード | evidence.mode | enum strict | balanced | broad | balanced | この 3 つの値 | 出典が回答をどの程度厳格に裏付ける必要があるかを指定します。 |
| 埋め込みブースト | reranking.embedBoost | number | 0.7 | スキーマ上の追加制限なし | 埋め込み類似度への重みです。再埋め込みは行いません。 |
| 時間ブースト | reranking.temporalBoost | number | 0.15 | スキーマ上の追加制限なし | 時間信号がある場合の最新性への重みです。 |
| リランク候補 topK | reranking.topK | integer | 30 | 1〜200 | リランク対象の候補数です。これだけでは回答結果の件数は増えません。 |
| 証拠抽出を有効化 | evidence.extractionEnabled | boolean | オン | — | オフのとき、証拠の上限と証拠選択プロンプトは無視されます。 |
| 主要証拠の上限 | evidence.primaryMax | integer | 8 | 0〜30 | 証拠抽出を有効化がオンになるまで無視されます。 |
| 補足証拠の上限 | evidence.supplementaryMax | integer | 12 | 0〜60 | 証拠抽出を有効化がオンになるまで無視されます。 |
| 引用の最大文字数 | evidence.quoteMaxChars | integer | 2000 | 100〜12000 | 証拠抽出を有効化がオンになるまで無視されます。 |
| 引用を必須にする | evidence.requireCitations | boolean | オン | — | 回答に出典の引用を求めます。それでもチェックに通らない場合はあります。 |
| 独立した段階タイトルなし | evidence.showAllRankedChunks | boolean | オフ | — | シリアライズされますが、6 つ目の段階を追加するものではありません。 |
| 関連性フィルタープロンプト | policySnapshot.relevancePrompt | string | ロケール既定文 | 最大 12000 文字 | 英語の既定文と一致する場合は省略されます。 |
| 証拠選択プロンプト | evidence.promptGuidance | string | ロケール既定文 | 最大 12000 文字 | 証拠抽出を有効化がオンになるまで無視されます。 |
| 分析する最大ファイル数 | policySnapshot.maxDocuments | integer | 5 | 1〜30 | 分析に入る文書の最大数です。 |
| ファイルあたりの段落数 | policySnapshot.maxParagraphsPerDoc | integer | 8 | 1〜30 | 分析対象文書ごとの段落上限です。 |
| 最大コンテンツ文字数 | policySnapshot.maxContentChars | integer | 2000 | 200〜12000 | 分析プロンプトの文字数予算です。 |
| 分析の最大トークン | policySnapshot.analysisMaxTokens | integer | 2000 | 100〜32000 | 文書ごとの分析のトークン予算です。 |
| 文書分析プロンプト | policySnapshot.analysisPrompt | string | ロケール既定文 | 最大 12000 文字 | 英語の既定文と一致する場合は省略されます。 |
| 段階タイトルなし | policySnapshot.analysisOutputHint | string | 空欄 | 最大 6000 文字 | 入力した場合のみ送信され、空欄は省略されます。 |
| 合成の最大トークン | policySnapshot.synthesisMaxTokens | integer | 2000 | 100〜64000 | 最終回答のトークン予算です。 |
| 回答合成プロンプト | policySnapshot.synthesisPrompt | string | ロケール既定文 | 最大 12000 文字 | 英語の既定文と一致する場合は省略されます。 |
| 段階タイトルなし | policySnapshot.synthesisOutputHint | string | 空欄 | 最大 6000 文字 | 入力した場合のみ送信されます。 |
| 段階タイトルなし | guarantees.embedGuaranteeN | integer | 4 | 0〜100 | シリアライズされますが、専用の段階ラベルはありません。 |
| 段階タイトルなし | guarantees.ceGuaranteeSources | integer | 3 | 0〜100 | シリアライズされますが、専用の段階ラベルはありません。 |
| 段階タイトルなし | guarantees.entityGuaranteePerSource | integer | 2 | 0〜100 | シリアライズされますが、専用の段階ラベルはありません。 |
上の行に無い、API が受け付けるオブジェクトは chunkRoles と discovery(フィールドの重みと段落の探索)です。スキーマは受け付けますが、ラボはこれらに段階のラベルを付けません。
保存と次の実行
未保存のデフォルトから始まります。ポリシーの保存は、フォームが組んだ名前とスナップショットを保存します。次の実行はそのスナップショットを送ります。保存した ID だけが、サーバーに置いたスナップショットを自動で読み込む、とはここでは述べません。プロンプトは、英語の既定文と一致するときだけスナップショットから省かれます。日本語の既定文は英語と違うので、省かれずに送られます。識別子の綴りは question、count、searchTopK のままです。
例
これらはプリセットではありません。検索だけを狭めるなら検索結果 topK を 10 にします。回答結果 topK は 30 のままです。回答を短く根拠づけるなら、証拠抽出をオンのまま、主要証拠の上限を 4 にします。遅延とトークンは減ることがありますが、回答が良くなるとは保証しません。
スクリーンショット
ラボ全体の画像および段階ごとの設定は上の図を参照してください。