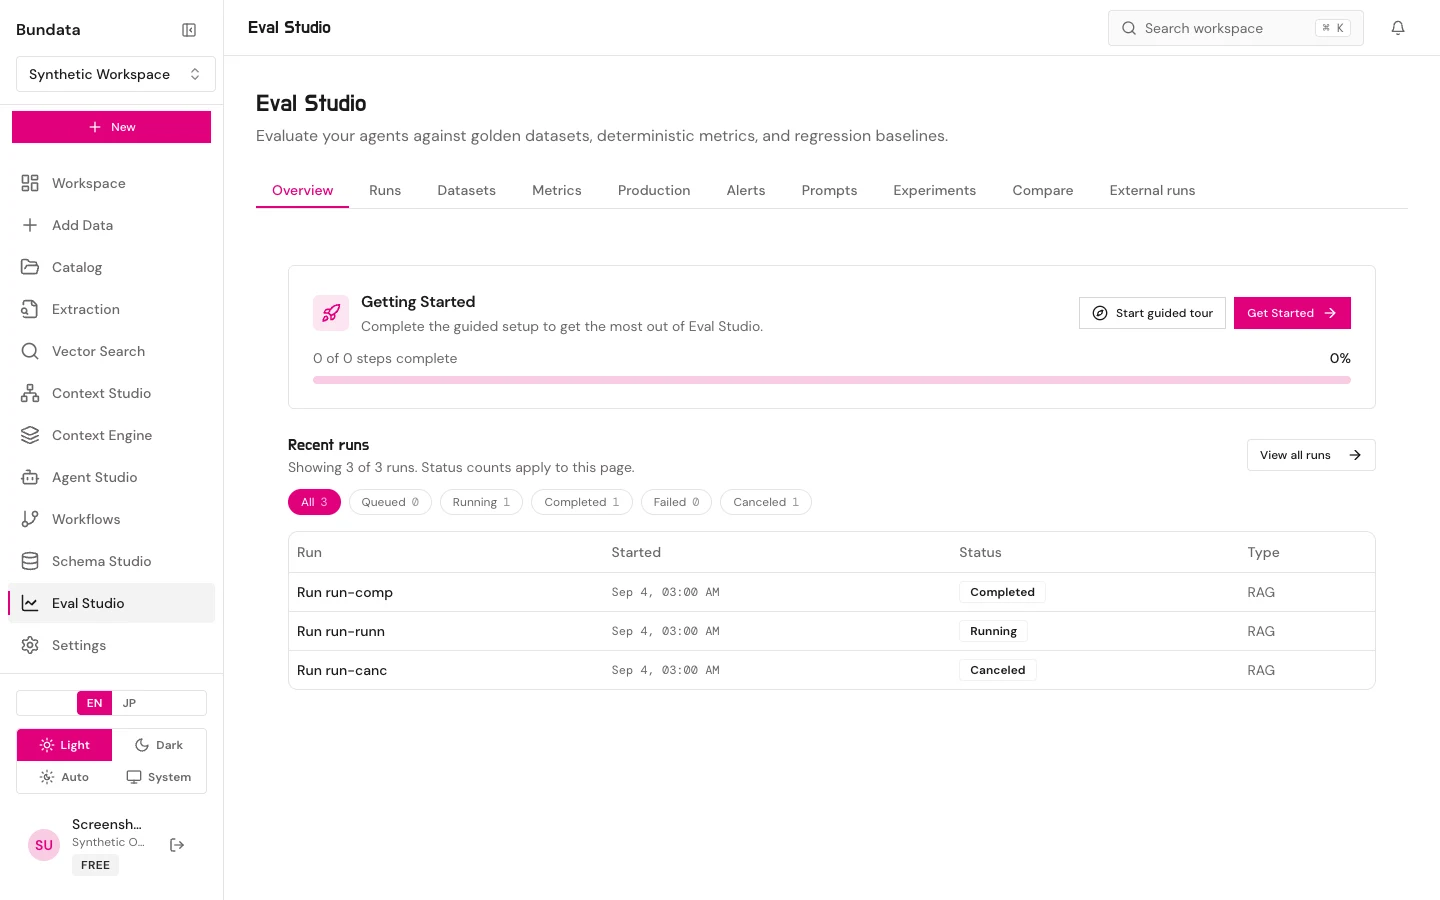
Eval Studio は凍結されたデータセットバージョンに対して、抽出、検索、コレクション回答、文書全体クエリ、コンテキストパック、ワークスペースエージェントを採点します。
評価
使い方
Eval Studio は、ワークスペースに既にある実行とデータセットを比較します。記録の閲覧には eval:read、実行の開始には eval:create が必要です。保存したメトリクス、データセット、プロンプト、アラートは、実行された評価ではありません。ゴールデンセットの顧客コンテンツはワークスペースに残ります。チケットには貼り付けません。
実行、出力ソース、データセット
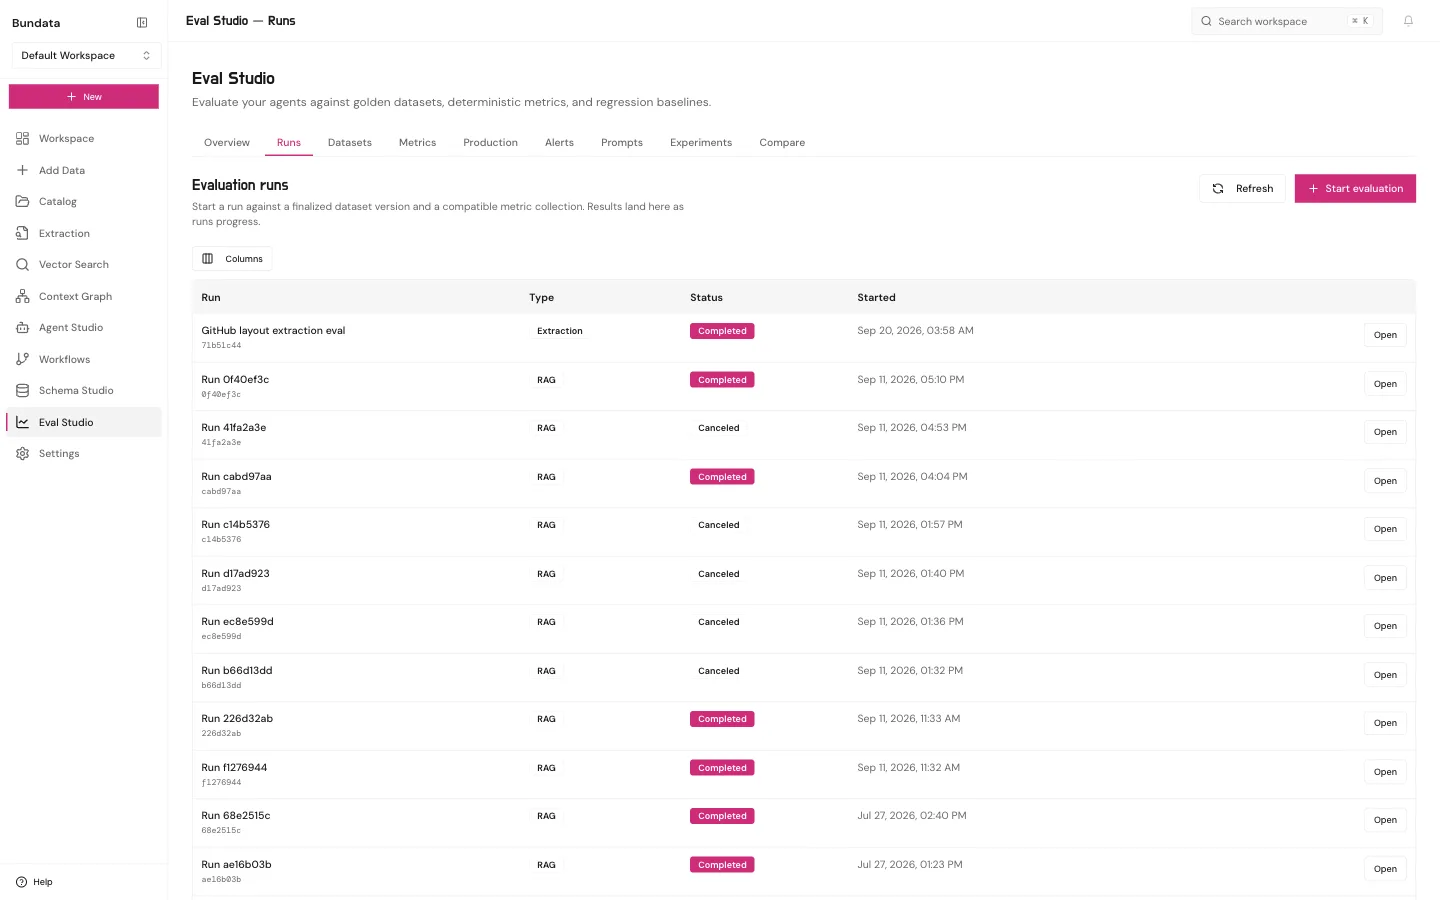
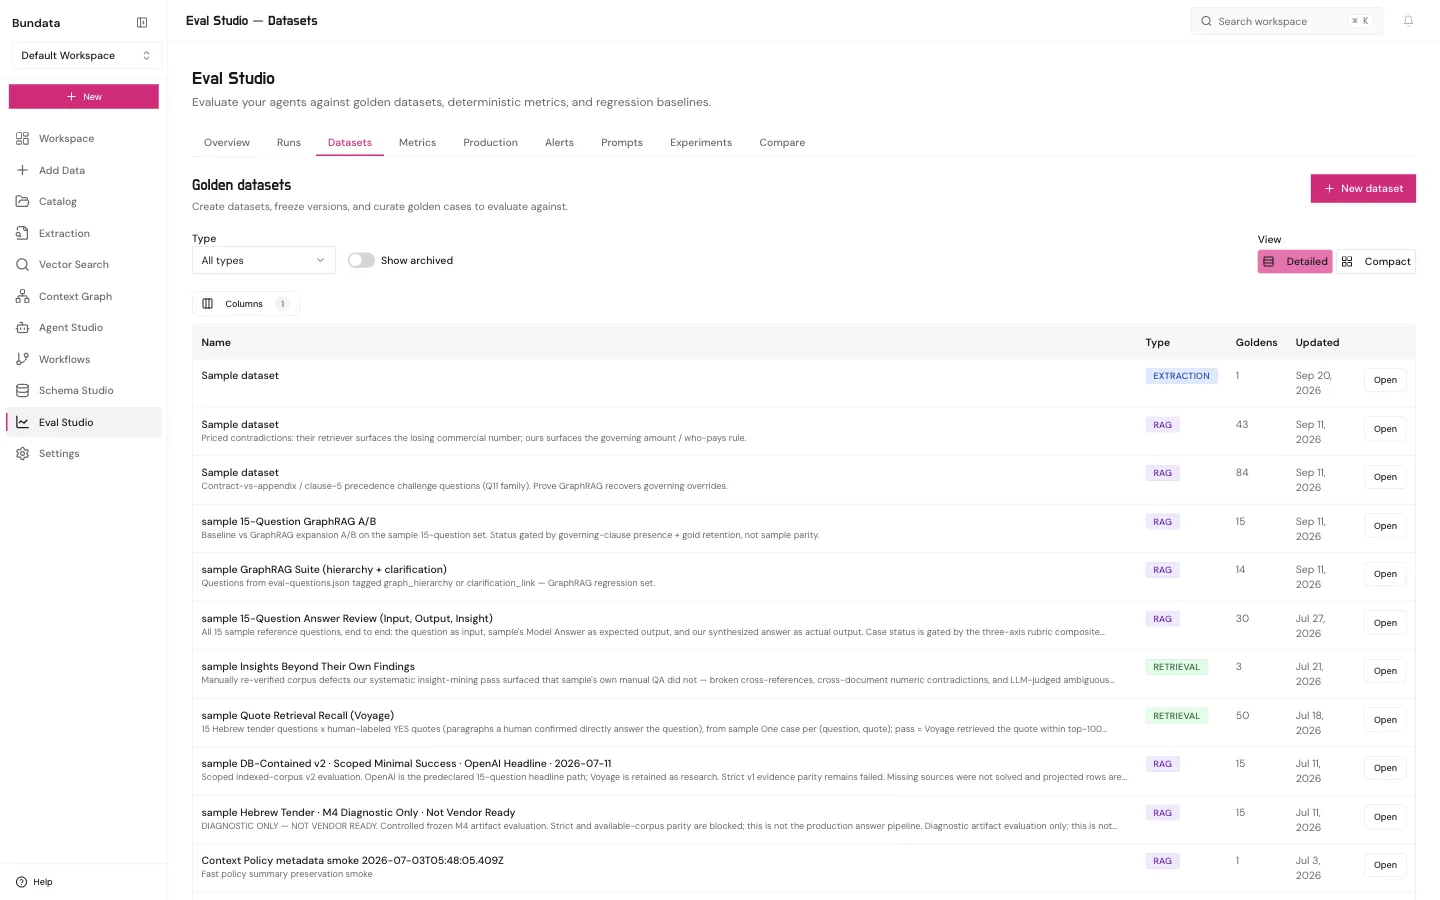
評価を始めるには実行ビューを開き、確定したデータセット版とメトリクス集を指定します(POST /api/w/:wsId/eval/runs)。
- 出力ソース:
agent_run、catalog_retrieval、recorded_conversation、prompt_versionに加え、RAG と検索のデータセットでは次のソースを選択できます。- コレクション回答(
collection_answers):graphEvidence(offまたはon)、chunkSizes(collection、main_only、three_sizes、またはトライアル用のcustomサイズ)、approvedContext(offまたはon)、fieldAnswers、およびansweringModel(OpenAI、Anthropic、Google)を固定してコレクションの回答パイプラインを実行します。 - 文書全体(
whole_document): 選択した 1〜20 件の文書に対して文書全体クエリを実行します。 - コンテキストパック(
context_pack): 指定したcontextSetIdとmaxTokensでエージェントコンテキストパックを構築します。 - ワークスペースツール付きエージェント(
workspace_agent): 探索エージェントをtools_onlyモード(1〜5 コレクション)またはcontext_set_firstモード(contextSetId)で実行し、精度、トークン数、ツール呼び出し回数、レイテンシ、米ドルコストのトレーススパンを記録します。
- コレクション回答(
- モデル選択: 各実行は受付時に
judgeModelとansweringModel(run_choice、workspace_choice、またはbundata_default)を固定し、別モデルへ勝手に差し替えることはありません。 - 再採点と保存済み回答の採点: 完了した実行に対して再度回答を生成することなく、新しいしきい値で再採点(
POST /api/eval/runs/:runId/rescore)したり、別のメトリクス集で保存済み回答を採点(storedAnswersOf)したりできます。回答を見た後にしきい値が選ばれているため(thresholdsSetAfterAnswers: true)、再採点された実行は コンテキストエンジン の回答パスを有効化するための証拠にはなりません。
メトリクス、メモリ能力、プロンプト、アラート
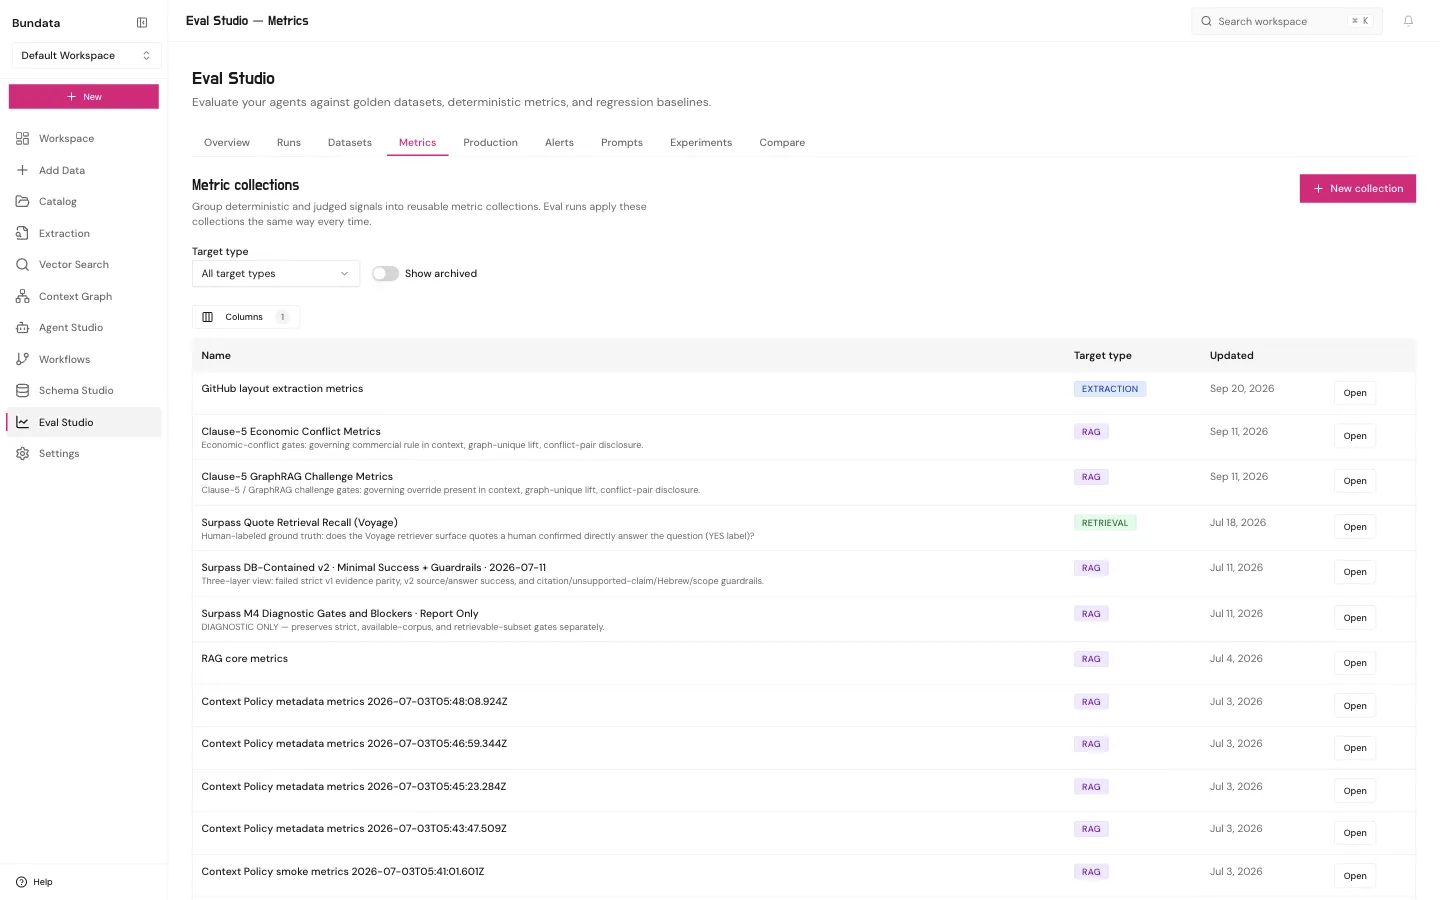
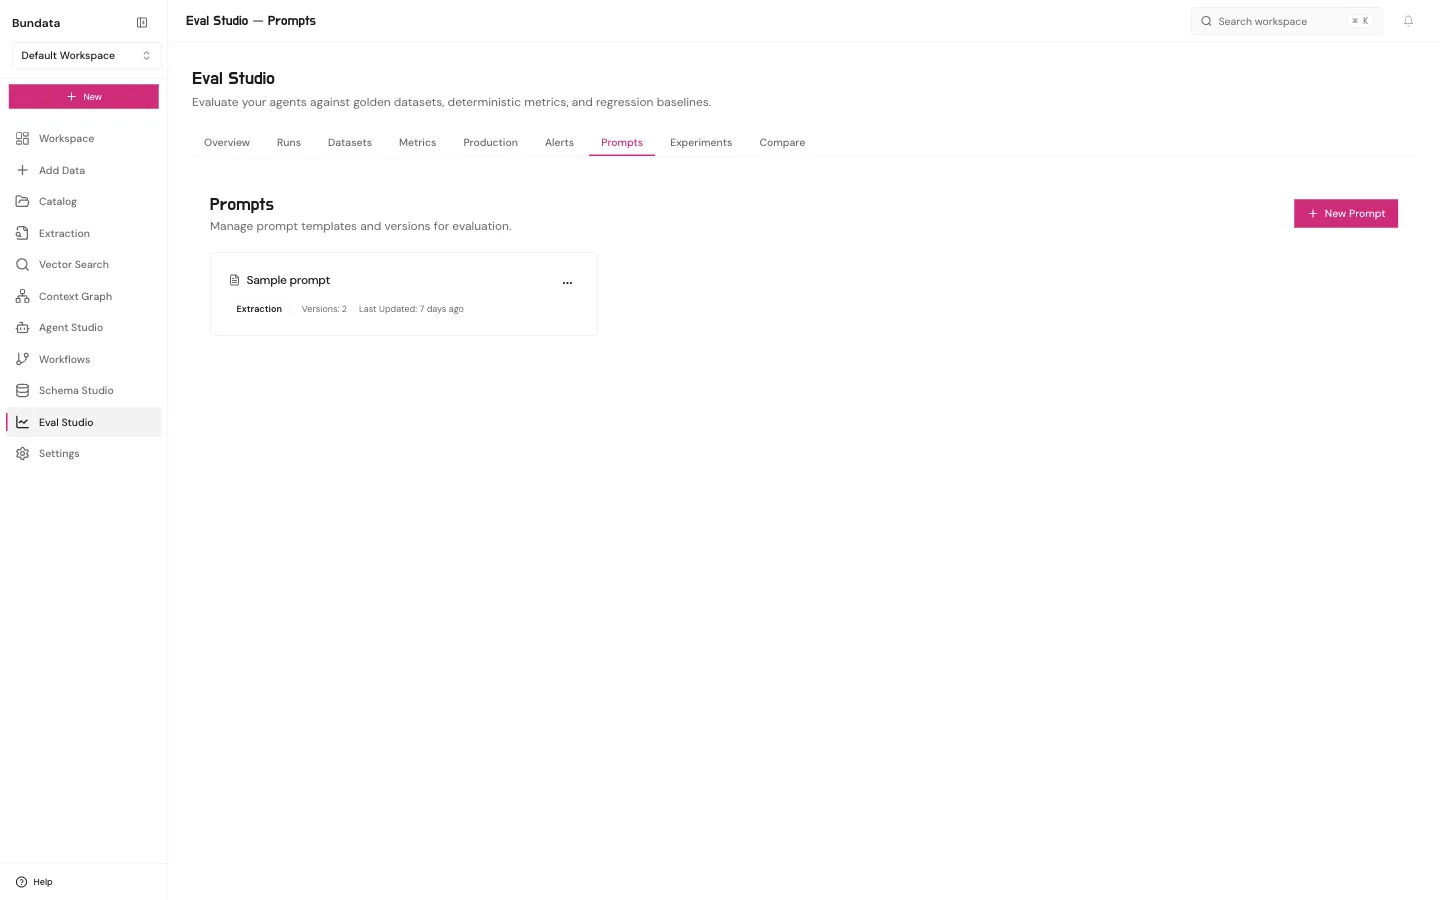
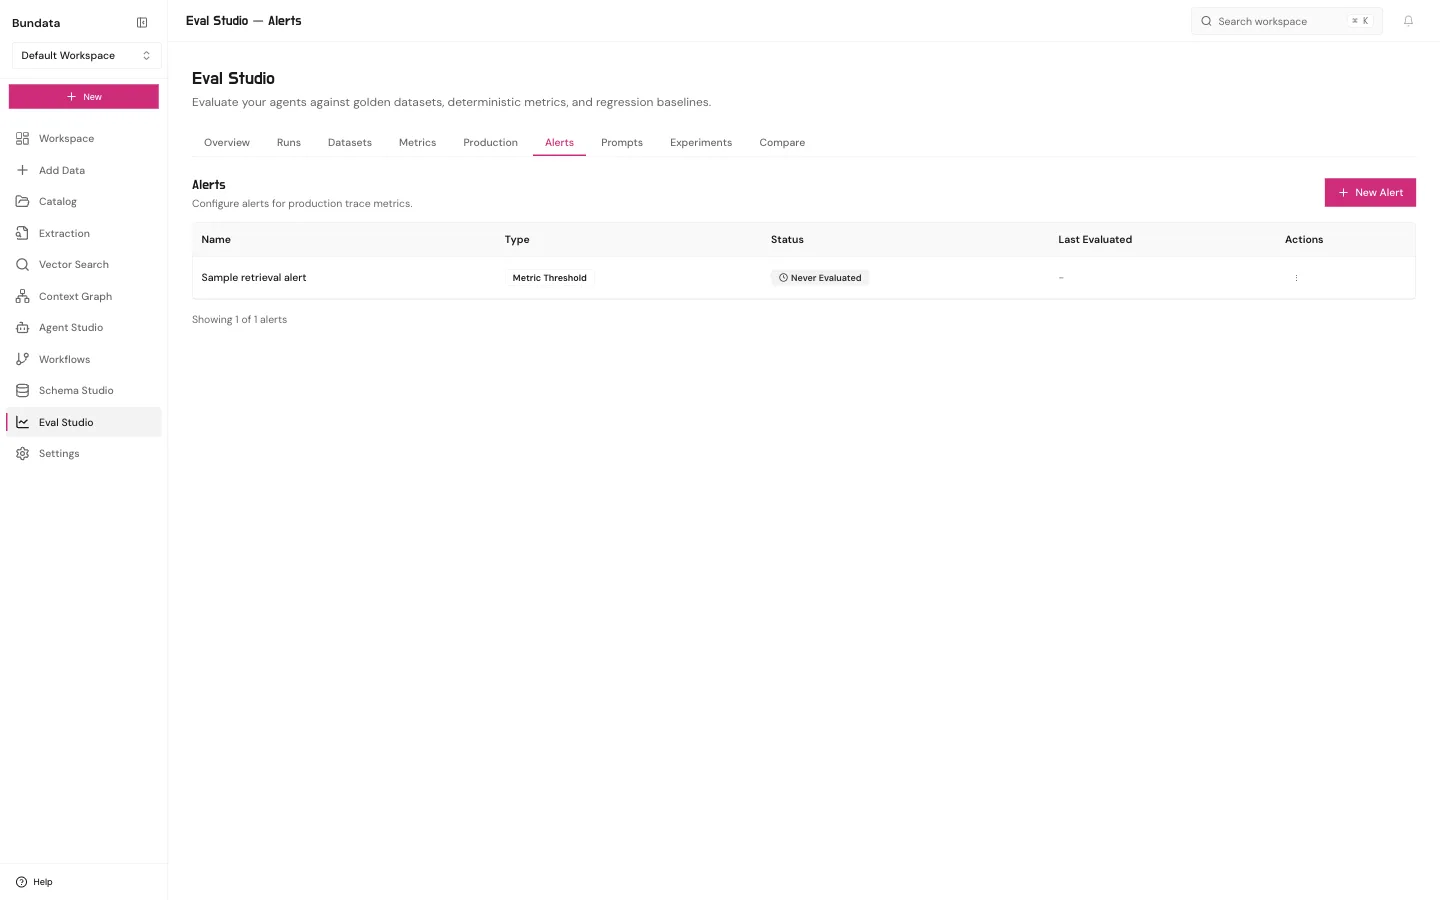
RAG と検索のゴールデンケースにはメモリ能力メタデータ(memoryJson: fact_lookup、multi_hop、as_of、as_known_at、knowledge_update、contradiction、ambiguous_source、abstention、history_diff、whole_document_listing、claim_verification、context_pack)を付与でき、組み込みのメモリとグラフメトリクス集(18 個の決定論的メトリクスおよび校正状態の表示付きジャッジ)で採点できます。
本番、実験、比較
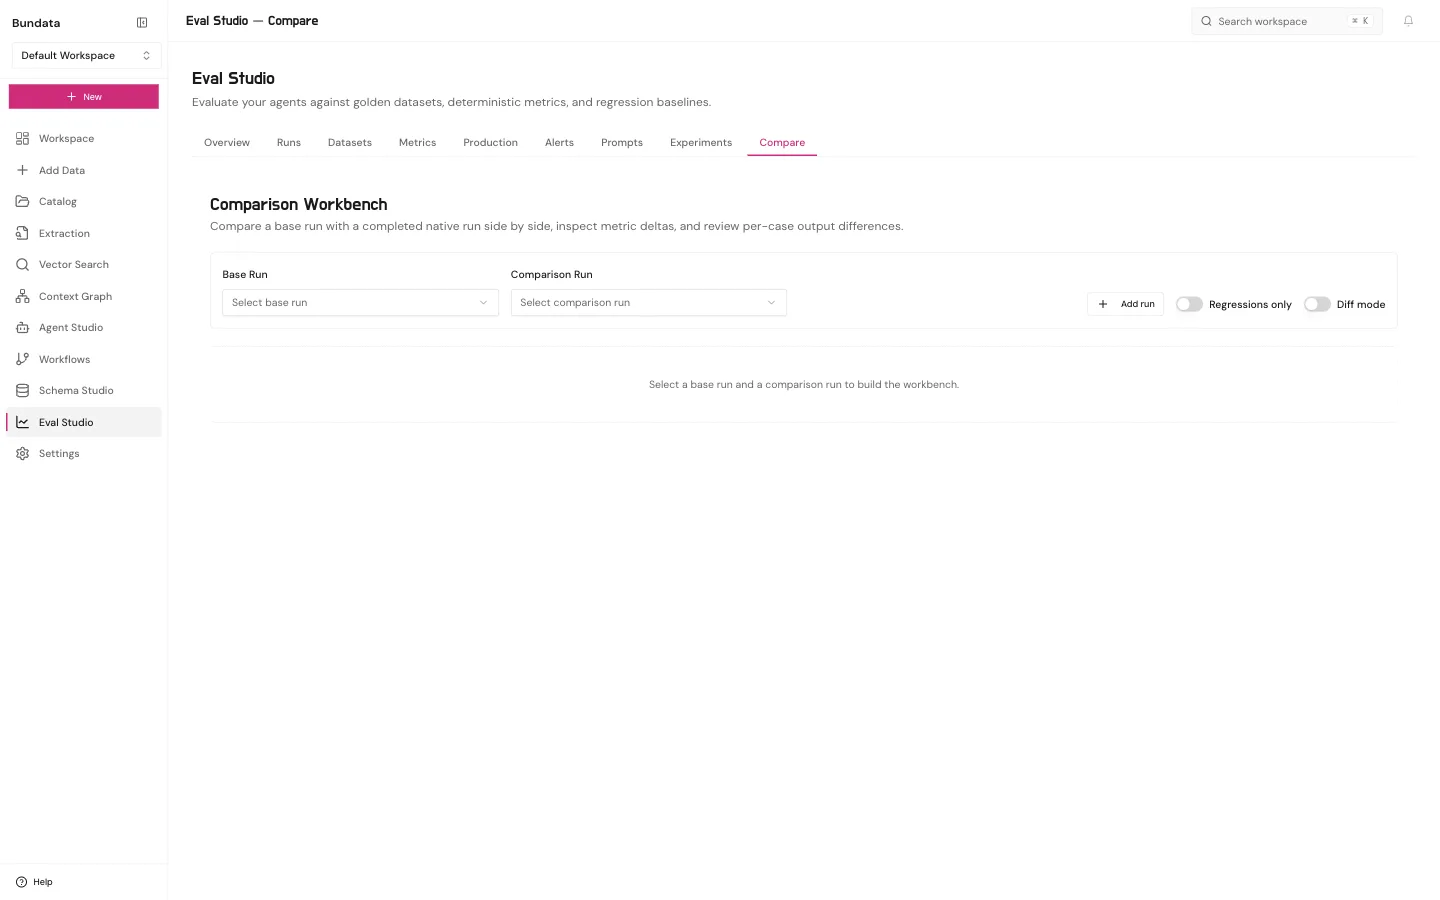
- チャンキング戦略の比較(
POST /api/w/:wsId/eval/chunk-strategy-comparisons): 同一コレクション・同一データセット版に対して 2〜3 通りのチャンクサイズ戦略を実行し、collection:update権限を持つユーザーが優れたトライアル戦略をコレクションへ直接適用できるようにします。 - 影響測定と承認済みコンテキストの検証: 実行比較(
GET /api/eval/runs/:runId/compare)は、精度、トークン数、ツール呼び出し、レイテンシ、コストについて 95% 対ブートストラップ信頼区間を計算します。また、キュレーターやスチュワードは ビジネスコンテキストライブラリ や コンテキストセット にデータセットを紐づけて変更のチェックや影響測定を実行できます。 - 外部実行(
/platform/eval-studio/external-runs): 文書本文を含まないベンチマークスコアボードや管理レーンのサマリー JSON(64 KiB以下)を読み取り専用でインポートできます。