実装されているソースは 6 種類です。保存した接続は取り込みではありません。
ソース接続
実装されているもの
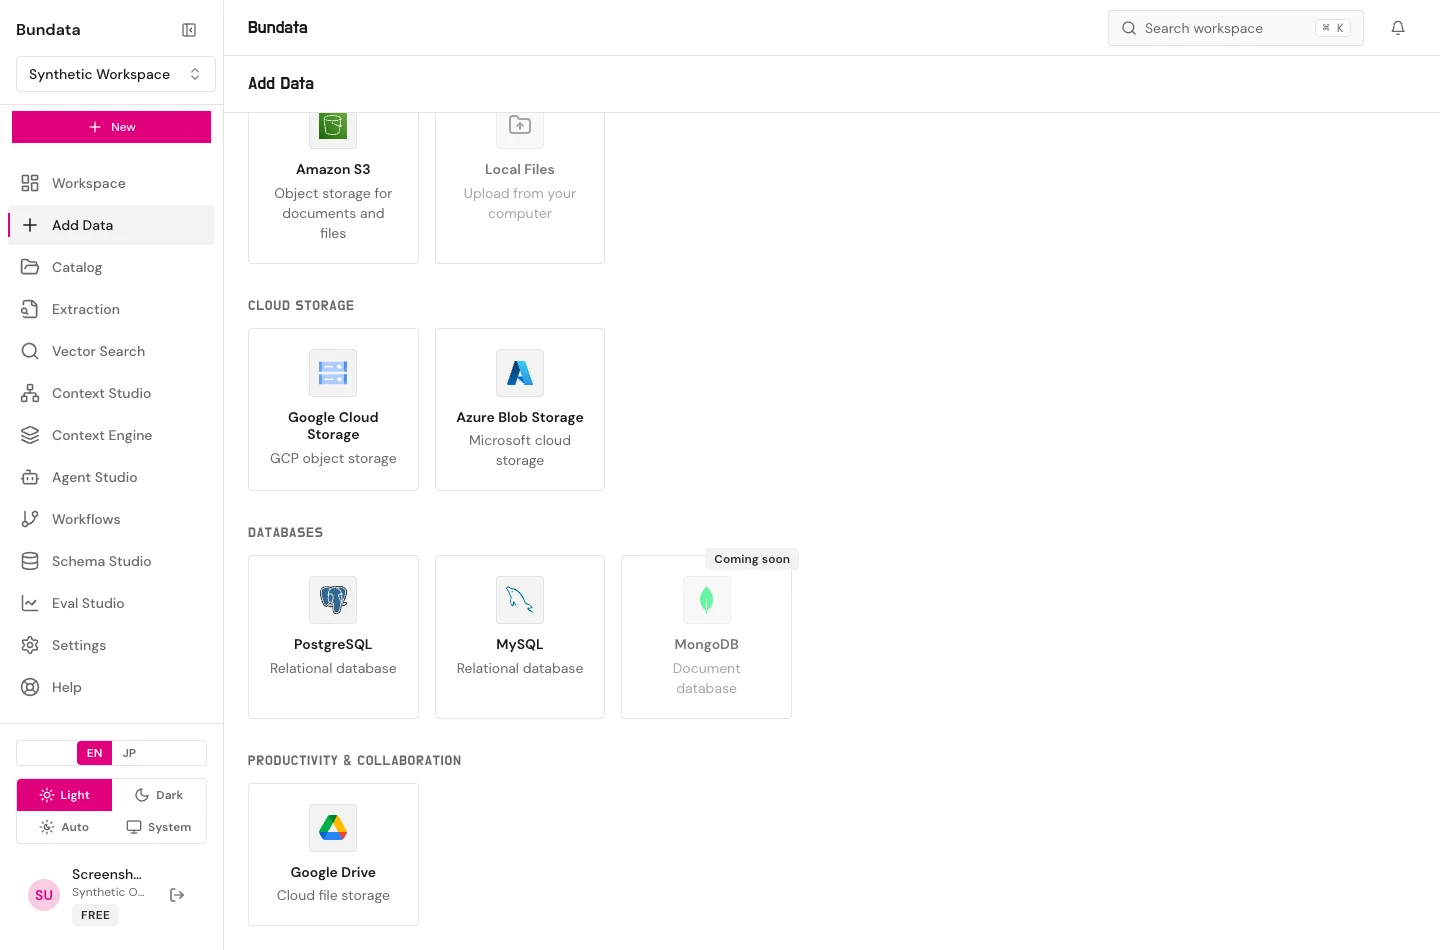
取り込みワーカーが実装しているソースは 6 種類です:Amazon S3(s3)、Google Cloud Storage(google_cloud_storage)、Azure Blob Storage(azure_blob_storage)、Google Drive(google_drive)、PostgreSQL(postgresql)、MySQL(mysql)。
登録、読み取り確認の成功、キューに入った取り込みは別です。抽出スタジオやワークフローの取り込みステップでは、保存済みの接続からインポートできます。手動の HTTP トリガー POST /api/w/:workspaceId/connections/:connectionId/source-ingest が受け付けるのは s3 と postgresql です。SharePoint、Gmail、Confluence、および多数のコネクタを並べた古い説明は、実装されたソース設定ではありません。
Amazon S3
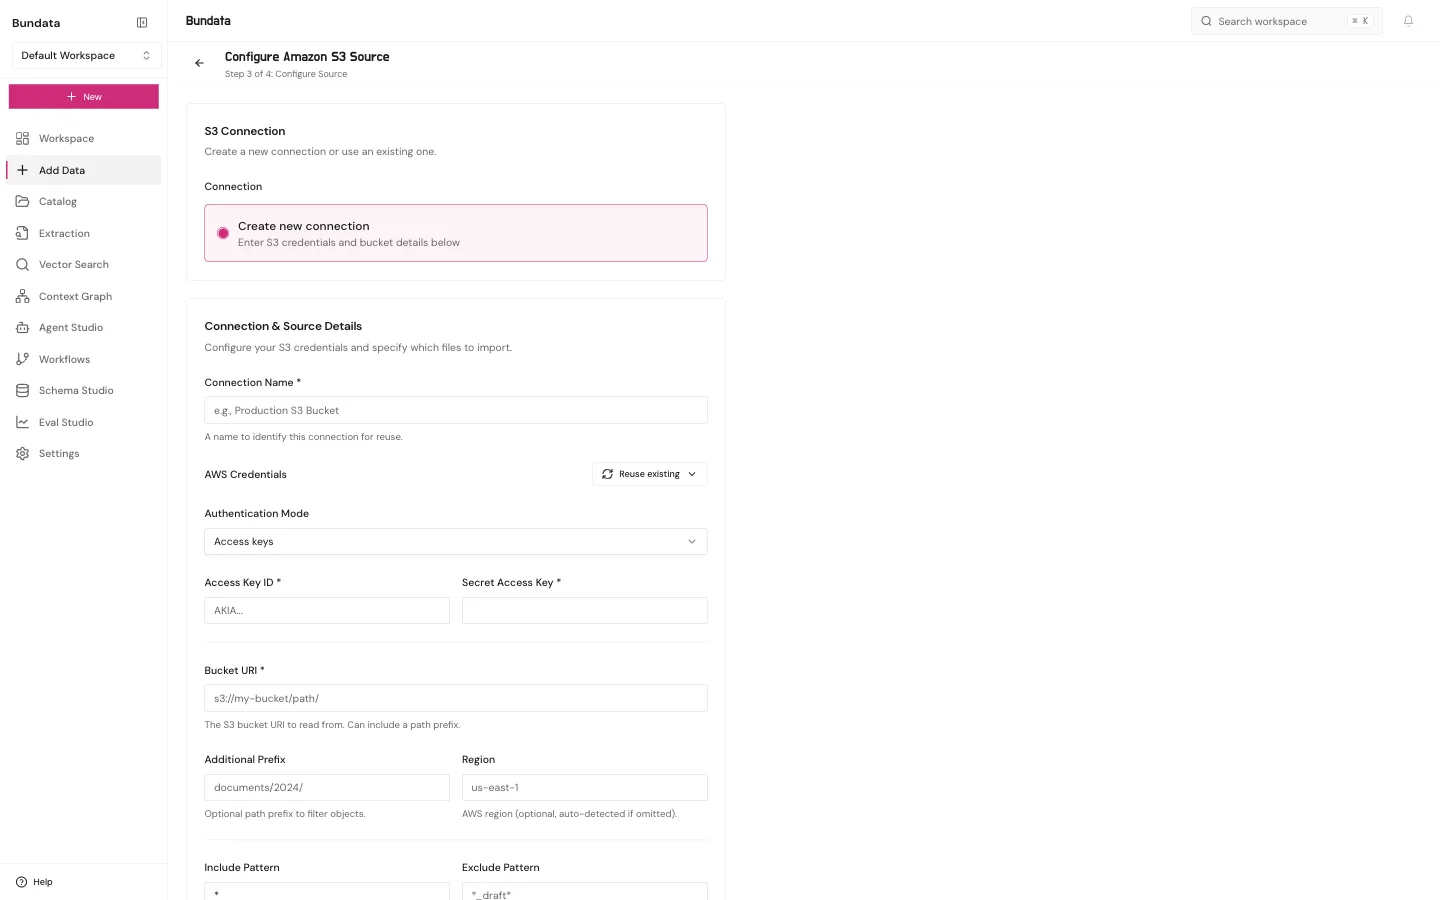
ソースのフィールドは bucketUri(必須)、prefix、region、recursive(既定 true)、customEndpointUrl です。認証はアクセスキー(accessKeyId、secretAccessKey、任意の sessionToken)、またはバケット方針が許す公開の anonymous です。プレフィックスに絞った読み取り方針を使います。アカウント全体の管理者キーは使いません。
読み取りまたは一覧の確認は、設定した範囲をワーカーが一覧または取得できたことを意味します。送信先への書き込み権限ではなく、オブジェクトがコレクションへコピーされたことでもありません。
Google Cloud Storage
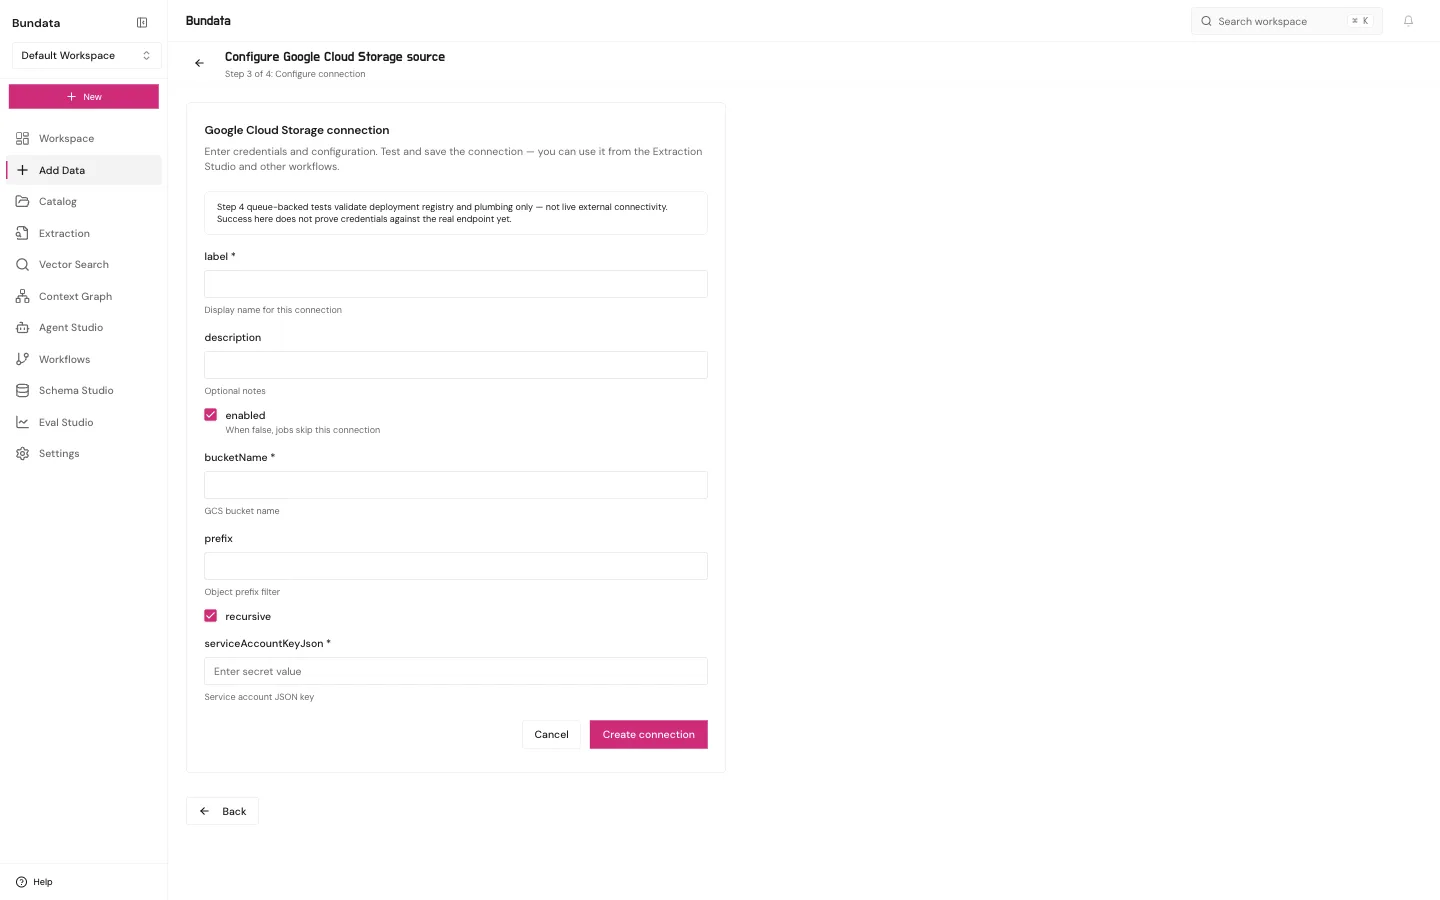
ソースのフィールドは bucketName(必須)、prefix、recursive(既定 true)、秘密の serviceAccountKeyJson です。サービスアカウントには、そのバケットとプレフィックスだけのオブジェクト読み取りを与えます。このコネクタの仕様上の確認はコンテナアクセス確認です。書き込み権限ではなく、S3 または PostgreSQL の取り込みルートでもありません。
Azure Blob Storage
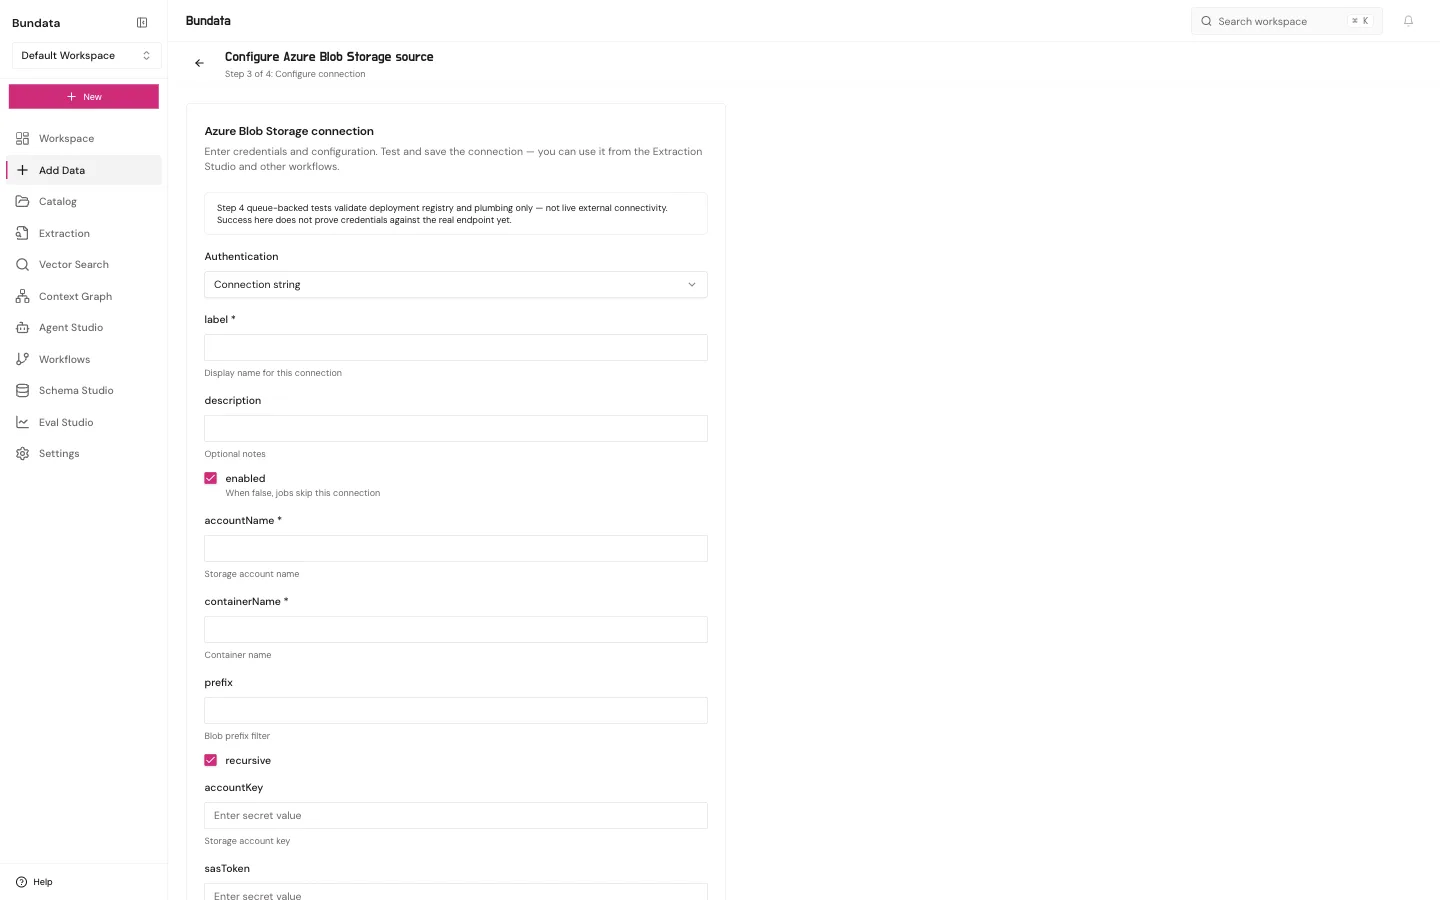
ソースのフィールドは accountName、containerName、prefix、recursive(既定 true)です。秘密情報は認証により accountKey、sasToken、connectionString のいずれかです。SAS は一つのコンテナーの読み取りと一覧に絞ります。container_access_check はそのコンテナーの読み取りであり、書き込みではありません。
Google Drive
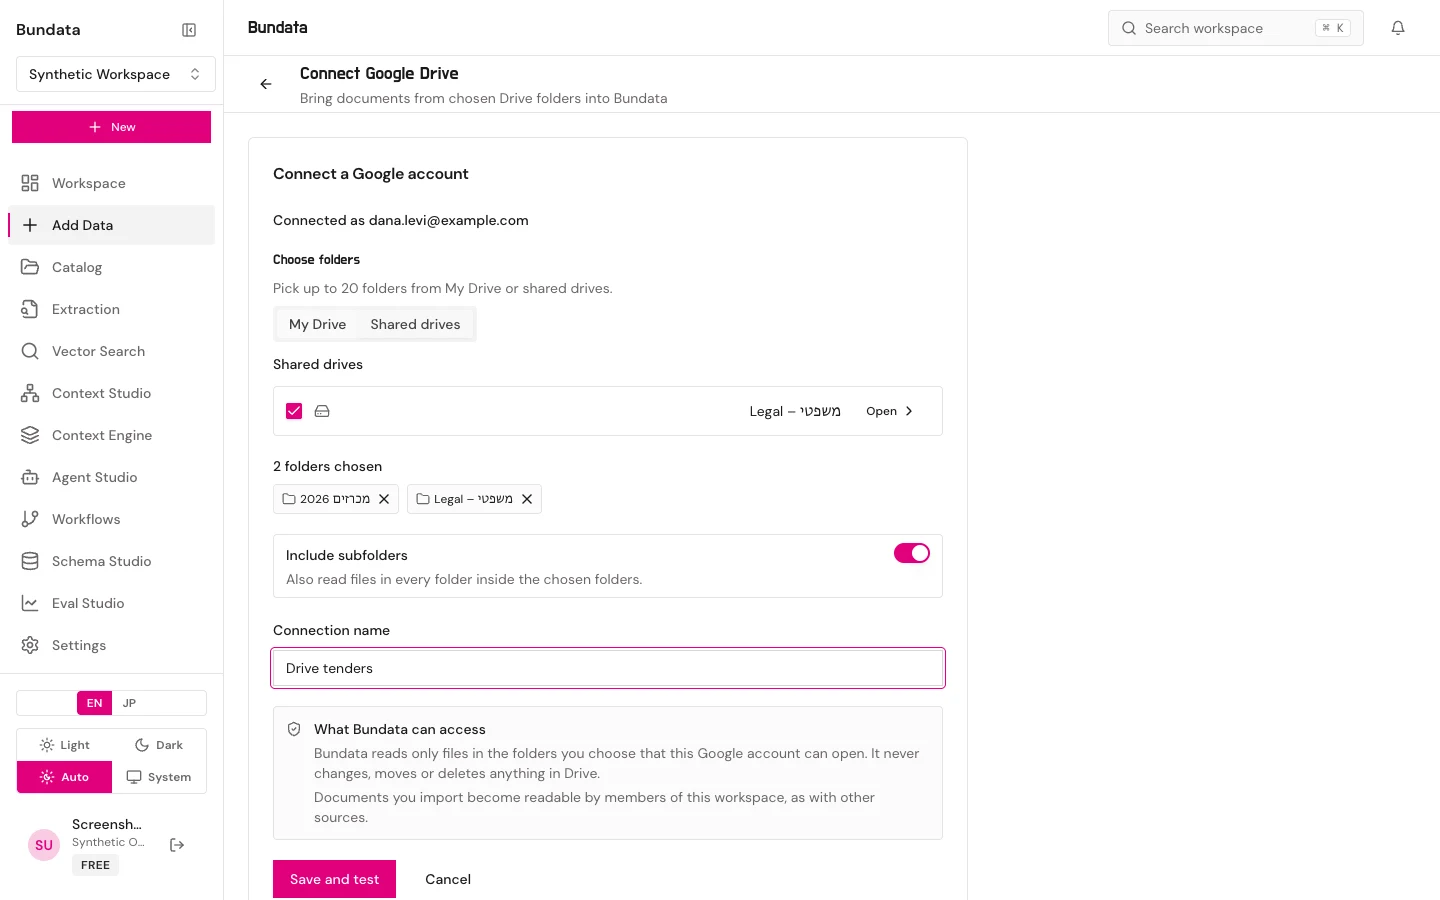
保存型ワークスペースにサインインしたブラウザセッションから データ追加 → Google Drive を開きます(デプロイのコネクタフェーズ 2 以上および Google OAuth 設定が必要です)。
- PKCE 付き読み取り専用 OAuth: トップレベルウィンドウで
https://www.googleapis.com/auth/drive.readonlyのみをオフラインアクセス付きで要求し、/auth/google-drive/callbackに戻ります。リフレッシュトークンは接続の暗号化シークレット(refreshToken)として保存され、アクセストークンはメモリ内のみに保持されログや応答には一切出ません。 - フォルダとファイル: マイドライブまたは共有ドライブから最大 20 個のフォルダを選択でき、
includeSubfolders(最大 20 階層)を指定できます。Google ドキュメントは.docx、スプレッドシートは.xlsx、スライドは.pdfとして取り込まれます。 - 上限と同期: ダウンロードファイルあたり最大
25 MiB、エクスポートされる Google ファイルあたり最大10 MB、1 回のインポート実行あたり最大500件の新規ファイル、最大 50 ページの継続ジョブに対応します。名前変更や移動されたファイルは Drive ファイル ID によって重複せず更新されます。Google 側でアクセスが取り消された場合は Reconnect が表示されます(同じ Google アカウントでの再接続が必要です)。
PostgreSQL と MySQL
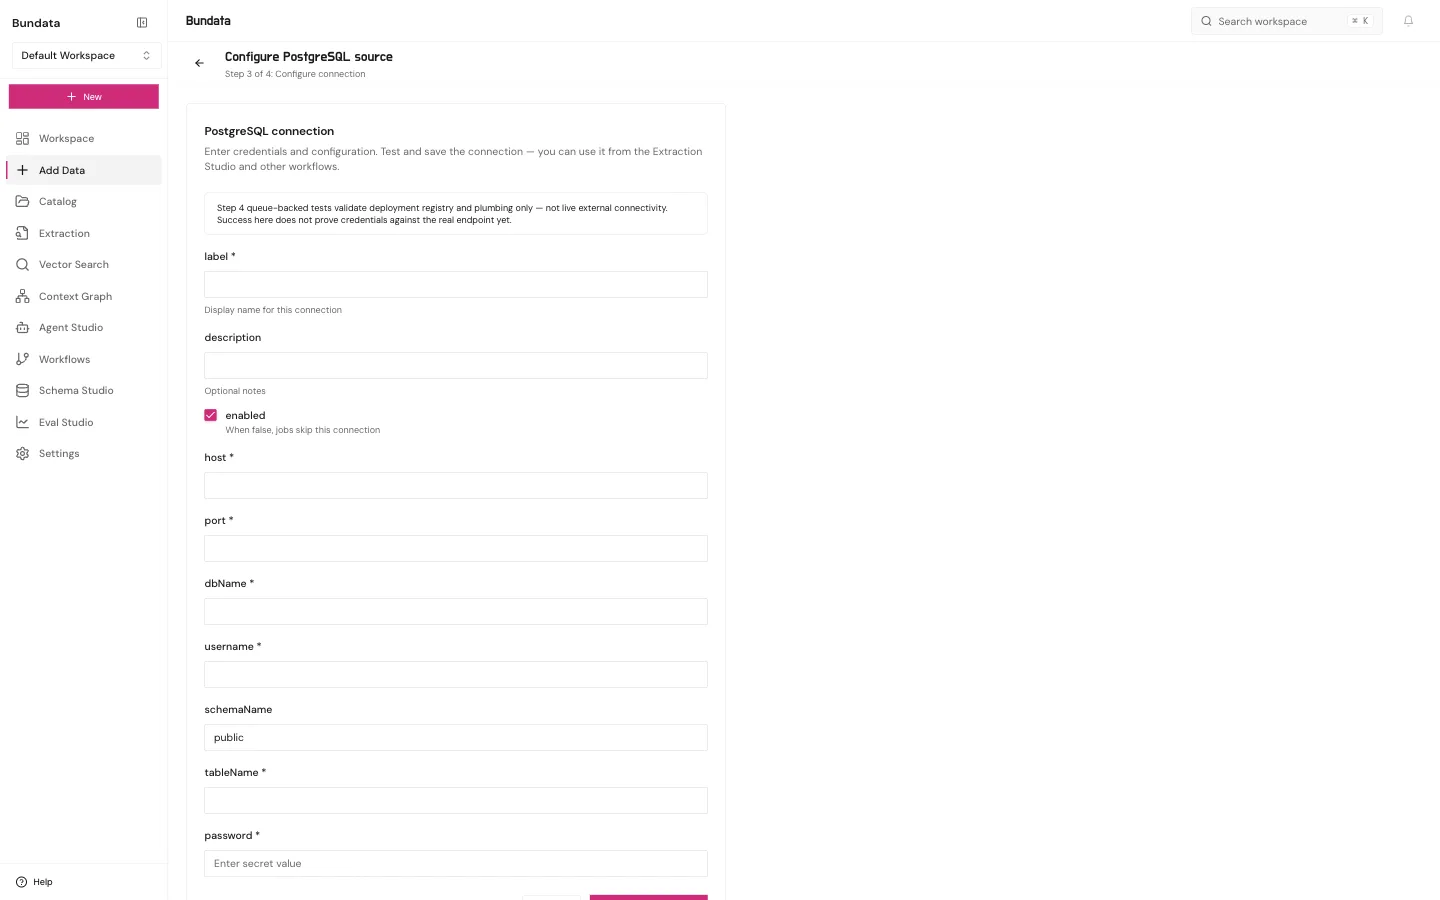
PostgreSQL のソースフィールドは host、port、dbName、username、password、任意の schemaName(既定 public)、必須の tableName です。そのテーブルに対する読み取り専用のデータベースユーザーを使います。
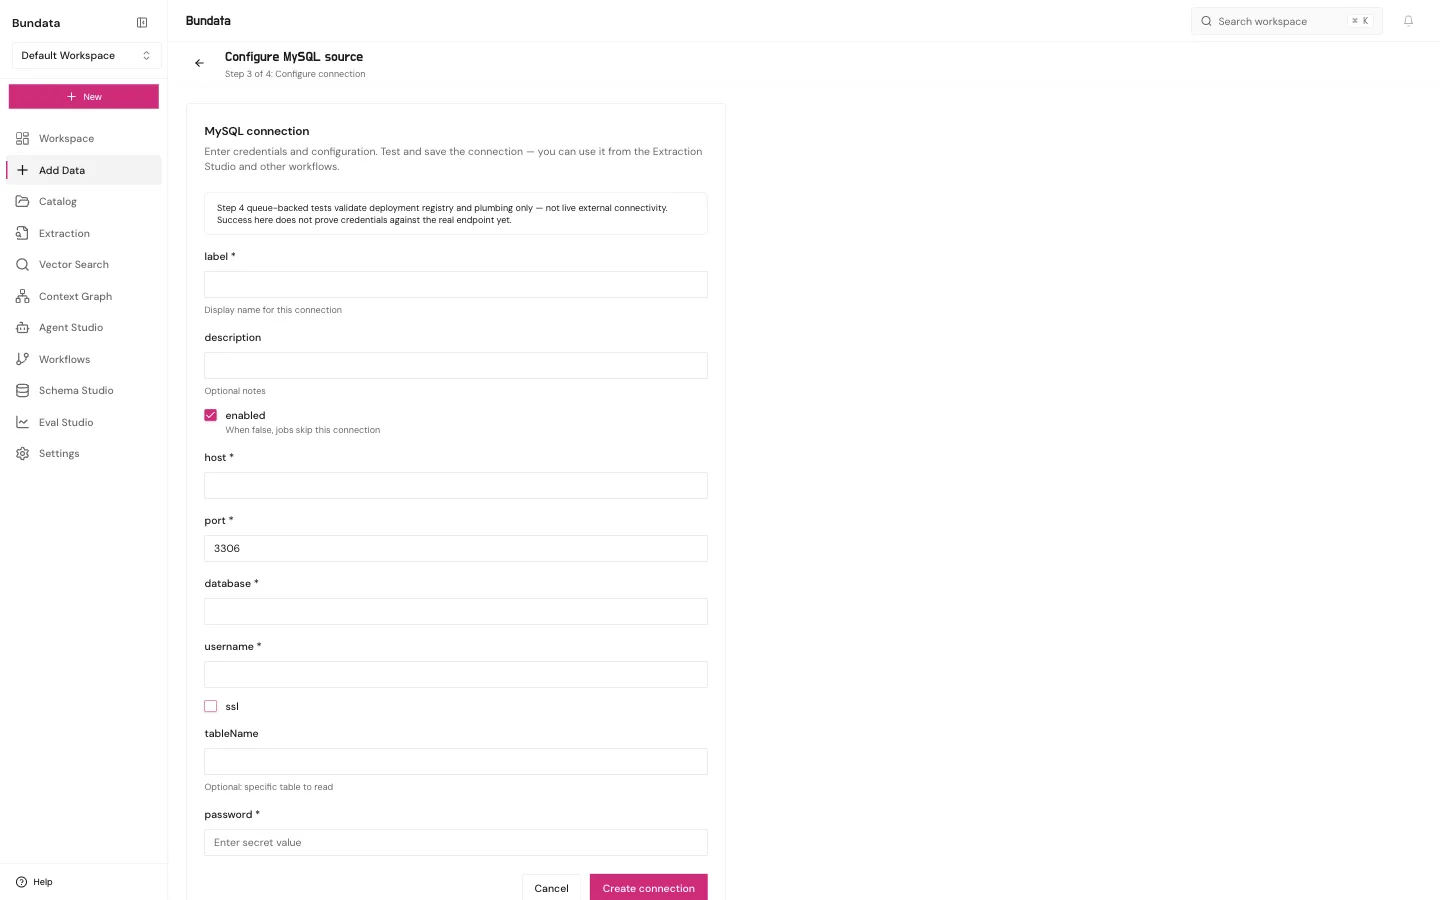
MySQL のソースフィールドは host、port(既定 3306)、database、username、password、ssl(既定 false)、任意の tableName です。また、コンテキストスタジオ → Data では PostgreSQL と MySQL 接続のメタデータスキーマを読み取ることもできます。
HTTP の source-ingest 本文は { collectionId, maxObjects?, prefix?, progressiveDiscovery? } です。maxObjects は 1 から 50 の整数です。ジョブがキューに入ると応答は { accepted: true, jobType: "connection.source.ingest", jobId, summary } です。jobId が null のときはサービス利用不可です。キューに入ったことは挿入済みではありません。新しい行はコレクションのドキュメントを確認します。データベース取り込みは行 JSON を抽出テキストとして保存します。送信先への書き込みの証明ではありません。
復旧
テストが失敗したままなら、ホストへの到達、プレフィックスまたはテーブル名、秘密情報が選んだ認証方法と一致するかを確認します。接続上で秘密情報をローテーションします。チケットには貼り付けません。Google Drive 接続が source_reauthorization_required を返した場合は、データ追加または設定 → 接続で同じ Google アカウントを使って Reconnect を実行します。読み取りの失敗は、コレクションに既にあるドキュメントを削除しません。