抽出は承認済みスキーマを埋め、引用付きの正規化フィールド値を記録し、メインおよびマルチサイズの Smart Bites を生成します。
抽出の概要
前提
保存型ワークスペース、読み取れるドキュメント、承認済みスキーマ、抽出を実行できるロールが必要です。OpenAI、Anthropic、Google から特定のディスカバリーモデル(discoveryModel)や抽出エージェントモデル(extractionModel)を選択するか、ピッカーを Workspace default(設定 → AI モデル で設定)のままにできます。選択したモデルのプロバイダーが未接続または未承認の場合、文書処理が始まる前に拒否されます(MODEL_CHOICE_UNAVAILABLE、MODEL_NOT_APPROVED)。
出力
保存された実行(agent_runs、extraction_model_json に使用モデルの来歴を記録)、検証済みパッセージスパン引用を伴う正規化された学習済みフィールド値(field_value_citations)、およびソースドキュメントに結び付いた Smart Bites が生成されます。
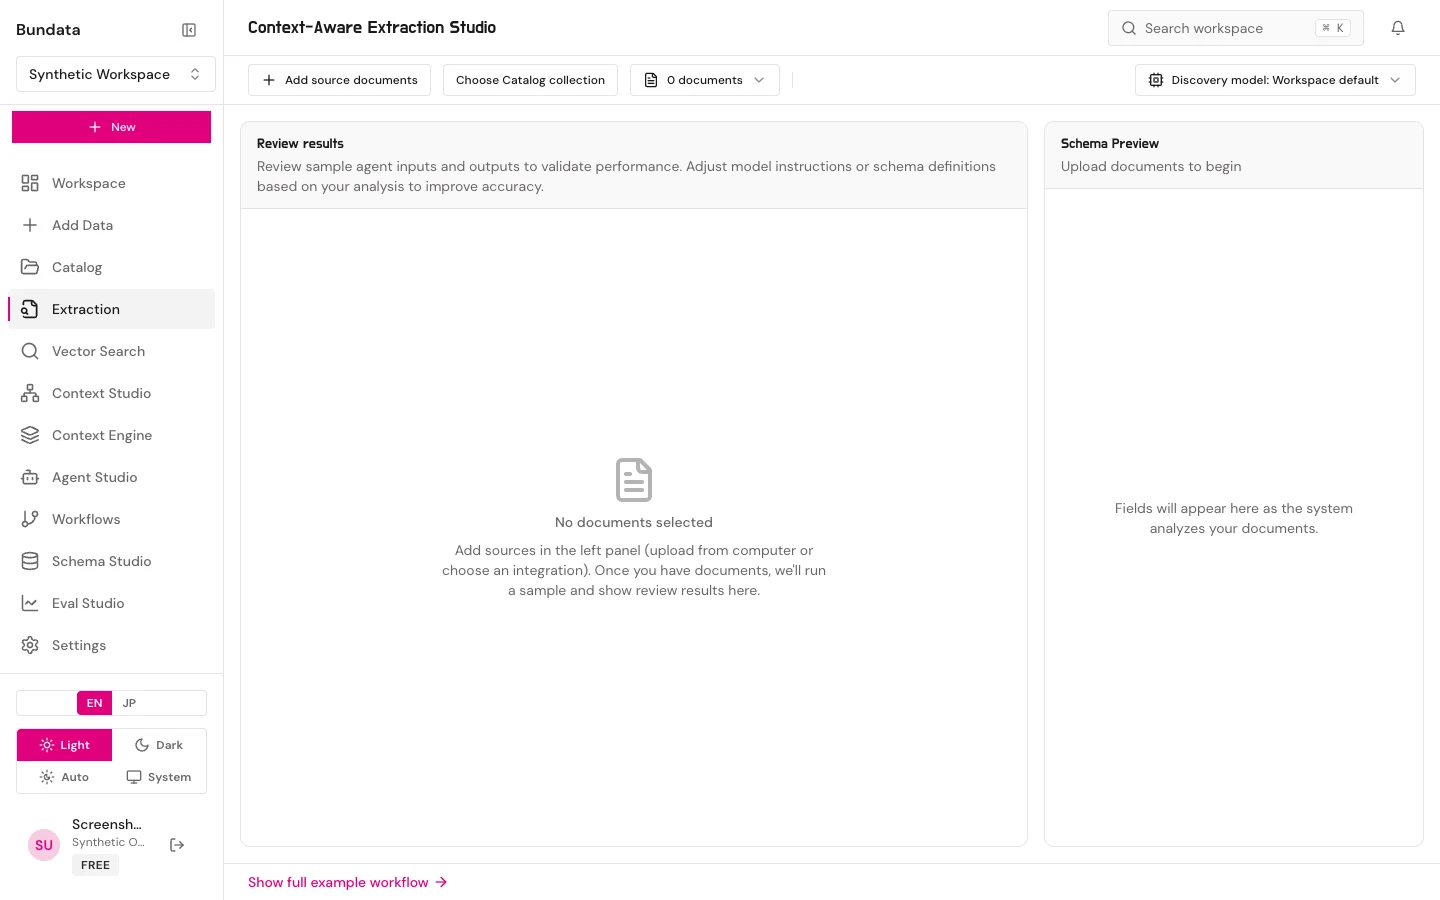
新しいコレクションは既定で 3 サイズのチャンキングプリセット(three_sizes: 段落境界で 1,500 文字のメインチャンクに加え、派生した 500 文字の文グループと 4,500 文字の複数チャンクウィンドウ)を使用します。抽出スタジオやコレクション詳細ページでチャンクサイズ(single、three_sizes、または 100〜12,000 文字の custom)をプレビュー・変更できます。また、ディスカバリーを経たコレクションでは検索時に語彙ルールが自動的に有効になります。
失敗
状態が error、または DOCUMENT_PROCESSING_QUEUE_UNAVAILABLE のようなキューのコードは、実行が終わっていないことを意味します。メッセージが再試行を言うときは同じジョブを再試行します。下書きエージェントが保存されていることを成功にしないでください。